Décrire une série de données
Types de variables, position, dispersion et représentations.
Le type de variable commande tout
Une variable qualitative se compte, une variable quantitative se mesure. Cette distinction détermine à elle seule les indicateurs utilisables, les graphiques pertinents et les tests applicables.
Parmi les quantitatives, on sépare encore le discret, qui ne prend que des valeurs isolées, du continu, qui peut prendre toute valeur d'un intervalle.
Position et dispersion
La moyenne est sensible aux valeurs extrêmes, la médiane ne l'est pas. Sur une distribution asymétrique ou comportant des valeurs aberrantes, la médiane décrit mieux le centre.
La dispersion se décrit par l'écart-type autour de la moyenne, ou par l'intervalle interquartile autour de la médiane. Un indicateur de position seul ne décrit jamais une série : deux séries de même moyenne peuvent n'avoir rien de commun.

Décrire avant de conclure
Le type de la variable commande la description. Une variable qualitative se décrit par des effectifs et des pourcentages. Une variable quantitative se décrit par un indicateur de position et un indicateur de dispersion, toujours les deux — une moyenne seule ne dit rien.
Le choix de l'indicateur dépend de la forme de la distribution. Si elle est symétrique, moyenne et écart-type conviennent. Si elle est asymétrique, la moyenne est tirée par les valeurs extrêmes et devient trompeuse : on lui préfère la médiane et les quartiles.
Les variables ordinales occupent une position intermédiaire. Leurs catégories sont ordonnées, mais les écarts ne sont pas mesurables : rien ne dit que passer du stade I au II équivaut à passer du II au III. Calculer leur moyenne n'a donc pas de sens ; on les décrit par des effectifs et des pourcentages, ou par la médiane.
Calculer à la main
Prenons cinq valeurs de glycémie : 4, 5, 5, 6 et 10 mmol/L. La moyenne est leur somme divisée par leur nombre, 30 / 5 = 6. La médiane est la valeur du milieu une fois la série rangée, ici 5 ; avec un nombre pair de valeurs, c'est la moyenne des deux valeurs centrales. Le mode, valeur la plus fréquente, vaut 5. L'étendue, différence entre maximum et minimum, vaut 6.
La variance mesure la dispersion autour de la moyenne : c'est la moyenne des carrés des écarts à la moyenne. Les écarts sont ici −2, −1, −1, 0 et 4, leurs carrés 4, 1, 1, 0 et 16, de somme 22. Pour décrire un échantillon et estimer la variance de la population, on divise par n − 1 plutôt que par n, ce qui corrige une légère sous-estimation : 22 / 4 = 5,5. L'écart-type, racine carrée de la variance, vaut environ 2,3 mmol/L et s'exprime dans l'unité de la variable.
La valeur 10 tire la moyenne vers le haut mais ne change pas la médiane : c'est ce qui rend la médiane plus robuste face aux valeurs extrêmes.
Montrer les données
La boîte à moustaches résume une variable quantitative en un coup d'œil. La boîte s'étend du premier au troisième quartile et contient donc la moitié centrale des valeurs ; sa longueur est l'écart interquartile. Un trait marque la médiane. Les moustaches s'étendent jusqu'aux valeurs les plus éloignées restant à moins d'une fois et demie l'écart interquartile de la boîte ; au-delà, les valeurs sont dessinées une à une comme valeurs atypiques.
Dans un histogramme, c'est la surface de chaque barre, et non sa hauteur, qui est proportionnelle à l'effectif, ce qui compte quand les classes sont de largeurs inégales. Le nuage de points montre la relation entre deux variables quantitatives ; le diagramme en barres ou en secteurs, la répartition d'une variable qualitative.
Un graphique peut tromper. Un axe vertical qui ne commence pas à zéro exagère les différences ; une échelle différente entre deux graphiques côte à côte fausse la comparaison ; un pourcentage sans son effectif cache la fragilité d'un résultat fondé sur quelques sujets.
La loi normale et les valeurs usuelles
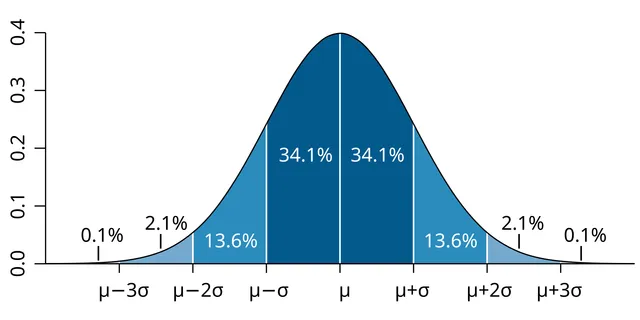
Pour situer une valeur dans une distribution normale, on la centre et on la réduit : on retire la moyenne et on divise par l'écart-type. On obtient un score z, qui dit à combien d'écarts-types de la moyenne se trouve la valeur. Environ 68 % des valeurs ont un z entre −1 et +1, 95 % entre −1,96 et +1,96, et 99,7 % entre −3 et +3.
Les courbes de croissance des enfants utilisent ce principe : une taille à −2 écarts-types situe l'enfant parmi les 2 à 3 % les plus petits de son âge.
Les valeurs usuelles d'un examen biologique sont en général définies comme l'intervalle qui contient 95 % des sujets en bonne santé. Par construction, 5 % des personnes saines ont donc une valeur hors de cet intervalle. Sur un bilan de vingt examens indépendants, une personne en parfaite santé a ainsi de bonnes chances d'avoir au moins un résultat « anormal » par le seul hasard.
Relier deux variables
Le coefficient de corrélation de Pearson mesure l'intensité d'une liaison linéaire entre deux variables quantitatives ; il varie de −1 à +1. Son carré indique la part de la variabilité de l'une qui est liée à celle de l'autre : une corrélation de 0,5 n'en explique qu'un quart. Une corrélation nulle signifie l'absence de liaison linéaire, pas l'absence de toute liaison : une relation en forme de U peut donner un coefficient proche de zéro.
Une corrélation ne prouve pas une causalité. Deux variables peuvent varier ensemble parce qu'une troisième les influence toutes deux : c'est un facteur de confusion. Les ventes de glaces et les noyades augmentent ensemble, parce que toutes deux augmentent avec la chaleur.
La régression linéaire va plus loin et décrit la relation par une droite, d'équation y = a + bx. La pente b indique de combien varie y, en moyenne, quand x augmente d'une unité. Pour deux variables qualitatives, on croise les effectifs dans un tableau de contingence.
Pourcentages : les pièges courants
Un pourcentage n'a de sens qu'avec son dénominateur : « 50 % de guérisons » ne pèse pas la même chose sur deux patients et sur deux mille. Il faut aussi savoir de quoi on prend le pourcentage : la part des fumeurs parmi les malades n'est pas la part des malades parmi les fumeurs.
Passer de 10 % à 15 % est une hausse de cinq points de pourcentage, mais une augmentation relative de 50 %. Les deux formulations sont exactes ; la seconde impressionne davantage, et c'est souvent elle qu'on met en avant.
Enfin, regrouper des données peut inverser une tendance : un traitement peut sembler meilleur dans chacun de deux sous-groupes et pire sur l'ensemble, si les sous-groupes sont de tailles et de gravités très différentes. C'est le paradoxe de Simpson, qui rappelle qu'il faut toujours se demander si les groupes comparés sont comparables.
58 questions corrigées accompagnent ce chapitre dans l'entraînement.
Sources et lectures
Ouvrages de référence
- Daniel Schwartz, Méthodes statistiques à l'usage des médecins et des biologistes, Flammarion Médecine-Sciences.
En accès libre
- 2.7 Measures of the Spread of the Data — OpenStax, Introductory Statistics 2e.
Dernière révision : . Texte sous licence CC BY-SA 4.0.