Tests d'hypothèse et risques d'erreur
Hypothèse nulle, p, risques alpha et bêta, puissance.
Les deux risques, et ce que p ne dit pas
Un test confronte une hypothèse nulle, celle de l'absence de différence, aux données observées. Deux erreurs sont possibles. Rejeter à tort l'hypothèse nulle est le risque alpha, fixé d'avance, généralement à cinq pour cent : c'est le faux positif. Ne pas la rejeter alors qu'elle est fausse est le risque bêta : c'est le faux négatif, et la puissance en est le complément.
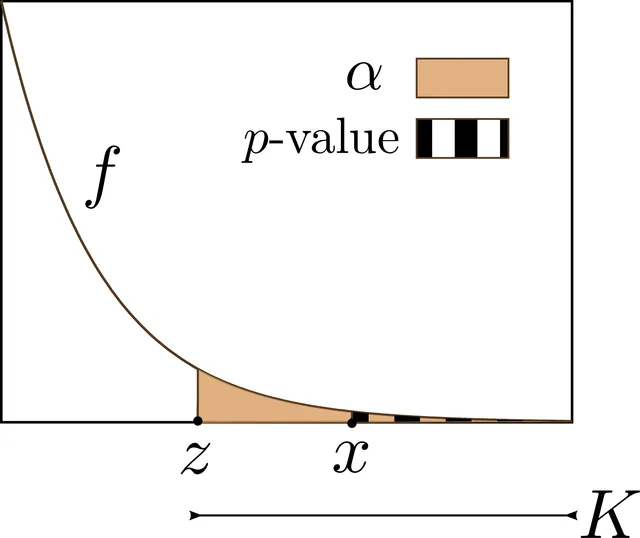
Le degré de signification p est la probabilité d'observer un résultat au moins aussi extrême si l'hypothèse nulle était vraie. Ce n'est pas la probabilité que cette hypothèse soit vraie, et ce n'est pas non plus une mesure de l'importance de l'effet. Un p de 0,04 ne signifie donc pas qu'il y a quatre pour cent de chances de se tromper en concluant à une différence.
Deux conséquences suivent. Un résultat non significatif ne démontre pas l'absence de différence : il peut refléter un simple manque de puissance. Et une différence significative n'est pas nécessairement importante : avec un effectif suffisant, un écart cliniquement négligeable devient statistiquement significatif.

La démarche d'un test
Un test suit toujours la même démarche. On formule l'hypothèse nulle, H0, et l'hypothèse alternative ; on fixe le risque alpha avant de voir les données ; on calcule, sous H0, une statistique de test dont la loi est connue ; on compare enfin sa valeur au seuil correspondant à alpha.
Si la statistique dépasse le seuil, on rejette H0 et la différence est dite significative au risque alpha. Sinon, on ne rejette pas H0 — ce qui n'équivaut pas à l'accepter : on conclut seulement que les données ne suffisent pas à montrer une différence.
Un test est bilatéral quand on cherche une différence dans les deux sens, unilatéral quand un seul sens est envisagé. Le choix se fait avant l'analyse ; passer au test unilatéral après coup, pour franchir le seuil, revient à doubler le risque alpha réellement pris.
Choisir le test
Le choix dépend de la nature des variables et du plan d'étude. Pour comparer deux proportions, on utilise le test du chi-deux, ou le test exact de Fisher quand les effectifs attendus sont faibles. Pour comparer deux moyennes, le test t de Student, qui suppose une distribution normale ou un effectif suffisant.
Quand les mesures sont appariées — le même sujet avant et après traitement —, on utilise les versions appariées de ces tests, qui travaillent sur les différences individuelles et gagnent beaucoup en puissance. Quand les conditions de normalité ne sont pas remplies, les tests non paramétriques fondés sur les rangs, comme ceux de Wilcoxon ou de Mann-Whitney, prennent le relais.
Pour étudier la liaison entre deux variables quantitatives, on teste le coefficient de corrélation. Une corrélation significative ne dit rien du sens de la relation, ni de son caractère causal.
Un khi-deux calculé pas à pas
Un essai compare deux traitements chez 200 patients, 100 par groupe. On observe 60 guérisons sous traitement A et 40 sous traitement B, soit 100 guérisons au total. L'hypothèse nulle est que le taux de guérison est le même dans les deux groupes.
Sous cette hypothèse, on attend dans chaque groupe la moitié de guérisons, puisque 100 patients sur 200 ont guéri : l'effectif attendu de chaque case vaut le total de sa ligne multiplié par le total de sa colonne, divisé par l'effectif total, soit 100 × 100 / 200 = 50. Les quatre cases attendues valent donc 50.
La statistique du khi-deux additionne, pour chaque case, le carré de l'écart entre observé et attendu divisé par l'attendu : (60 − 50)² / 50 = 2 pour chacune des quatre cases, soit 8 au total. Un tableau à deux lignes et deux colonnes a un degré de liberté ; le seuil au risque de 5 % vaut 3,84. Comme 8 dépasse 3,84, on rejette l'hypothèse nulle : la différence est significative. Le test n'est valide que si tous les effectifs attendus sont suffisamment grands, en général au moins 5.
Séries appariées ou indépendantes
Le choix du test dépend d'abord du plan de l'étude. Quand on compare deux groupes de sujets différents, les séries sont indépendantes. Quand on mesure deux fois les mêmes sujets — avant et après un traitement, œil droit et œil gauche — ou des sujets appariés un à un, les séries sont appariées : chaque sujet sert de témoin à lui-même, ce qui élimine une grande part de la variabilité entre individus et rend le test plus puissant.
Pour comparer deux moyennes, on utilise le test t de Student pour séries indépendantes ou pour séries appariées ; si les conditions de normalité ne sont pas remplies, leurs équivalents non paramétriques, fondés sur les rangs, sont le test de Mann-Whitney et le test de Wilcoxon. Pour deux proportions appariées, on utilise le test de McNemar.
Pour comparer plus de deux groupes, on n'enchaîne pas des tests deux à deux, ce qui multiplierait le risque d'erreur : on utilise une analyse de variance, ou son équivalent non paramétrique, le test de Kruskal-Wallis, qui teste d'abord globalement s'il existe une différence.
Le piège des tests multiples
Chaque test réalisé au risque de 5 % a une chance sur vingt de conclure à tort à une différence. Si l'on en fait vingt, indépendants, sur des données où rien n'est vrai, la probabilité d'obtenir au moins un résultat significatif par hasard vaut 1 − 0,95 puissance 20, soit environ 64 %.
Plusieurs parades existent. La plus simple, la correction de Bonferroni, divise le seuil par le nombre de tests : pour dix tests, chacun doit atteindre p < 0,005. Surtout, un essai doit définir à l'avance un critère de jugement principal, sur lequel porte la conclusion ; les autres analyses sont exploratoires.
Les analyses en sous-groupes méritent une méfiance particulière. Découvrir après coup qu'un traitement marche « chez les femmes de plus de 60 ans » alors qu'il ne marche pas dans l'ensemble est souvent un effet du hasard ; un tel résultat doit être confirmé par une nouvelle étude avant d'être cru.
Montrer qu'un traitement n'est pas moins bon
Un résultat non significatif ne prouve pas que deux traitements se valent : l'absence de preuve n'est pas la preuve de l'absence. Pour montrer qu'un nouveau traitement, moins cher ou mieux toléré, n'est pas inférieur au traitement de référence, il faut un essai de non-infériorité.
On fixe à l'avance une marge, la plus grande perte d'efficacité jugée acceptable. On conclut à la non-infériorité si l'intervalle de confiance de la différence entre les traitements reste entièrement du bon côté de cette marge. Un essai d'équivalence exige que l'intervalle reste à l'intérieur d'une marge de chaque côté.
Ces essais ont leurs propres pièges : une marge trop large permet de déclarer non inférieur un traitement nettement moins bon, et une étude menée avec négligence, où les deux groupes finissent par se ressembler, favorise à tort la conclusion de non-infériorité.
Analyser une survie
Quand le critère est le temps jusqu'à un événement — décès, rechute —, tous les patients ne sont pas suivis jusqu'à l'événement : certains sont perdus de vue, d'autres encore indemnes à la fin de l'étude. Leurs données sont dites censurées : on sait seulement qu'ils n'avaient pas eu l'événement jusqu'à une certaine date. Les exclure fausserait les résultats.
La méthode de Kaplan-Meier estime la probabilité de survie au cours du temps en tenant compte des censures ; elle donne une courbe en marches d'escalier, qui descend à chaque événement. La médiane de survie est le temps auquel la moitié des patients ont eu l'événement.
Le test du log-rank compare deux courbes de survie. Le rapport des risques instantanés, ou hazard ratio, résume l'écart : un hazard ratio de 0,7 signifie qu'à chaque instant, le risque de l'événement est réduit d'environ 30 % dans le groupe traité par rapport au groupe témoin.
58 questions corrigées accompagnent ce chapitre dans l'entraînement.
Sources et lectures
Ouvrages de référence
- Daniel Schwartz, Méthodes statistiques à l'usage des médecins et des biologistes, Flammarion Médecine-Sciences.
En accès libre
- 9.2 Outcomes and the Type I and Type II Errors — OpenStax, Introductory Statistics 2e.
- 9.5 Additional Information and Full Hypothesis Test Examples — OpenStax, Introductory Statistics 2e.
Dernière révision : . Texte sous licence CC BY-SA 4.0.