Échantillonnage et estimation
Fluctuation, intervalle de confiance, précision.
Ce qu'un intervalle de confiance dit vraiment
On n'observe qu'un échantillon, et on veut conclure sur une population. L'écart entre les deux est la fluctuation d'échantillonnage : elle est inhérente au tirage au sort et existe même avec une méthode parfaite. La statistique ne l'élimine pas, elle la quantifie.
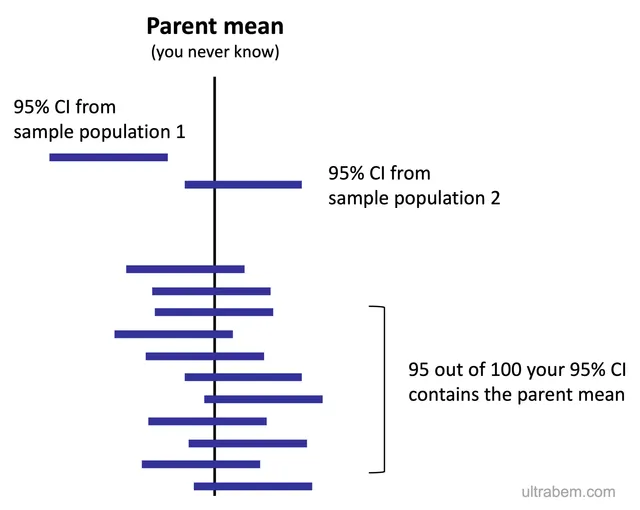
L'intervalle de confiance est cette quantification. Sa formulation exacte porte sur la procédure, non sur l'intervalle qu'on a sous les yeux : si l'on répétait l'étude un grand nombre de fois, quatre-vingt-quinze pour cent des intervalles ainsi construits contiendraient la vraie valeur. Il dit d'ailleurs plus qu'un test : le sens, l'amplitude et la précision de l'effet, là où le test ne rend qu'un verdict binaire.
Sa largeur croît avec la variabilité des données et décroît comme l'inverse de la racine carrée de l'effectif. Gagner un facteur deux en précision exige donc quatre fois plus de sujets — ce qui explique le coût rapidement prohibitif des études visant à détecter de petits effets.

Estimer une moyenne, estimer une proportion
L'estimation ponctuelle résume l'échantillon par un seul nombre : la moyenne observée pour une variable quantitative, la fréquence observée pour une variable qualitative. Elle ne dit rien, à elle seule, de sa propre précision.
Cette précision est mesurée par l'erreur standard, écart type de l'estimation d'un échantillon à l'autre. Pour une moyenne, elle vaut l'écart type des données divisé par la racine carrée de l'effectif. Il ne faut pas confondre les deux : l'écart type décrit la dispersion des individus, l'erreur standard celle de la moyenne.
Quand l'effectif est suffisant, l'intervalle de confiance à 95 % s'obtient en prenant l'estimation plus ou moins 1,96 erreur standard. Pour une proportion p observée sur n sujets, l'erreur standard vaut la racine carrée de p(1 − p)/n — approximation valable si np et n(1 − p) sont au moins égaux à cinq.
Échantillonner correctement
La précision d'une estimation dépend de l'effectif ; sa justesse dépend de la manière dont l'échantillon a été constitué. Seul un tirage au sort dans la population visée — l'échantillonnage aléatoire — garantit que chaque individu a la même probabilité d'être inclus, et permet d'appliquer les calculs d'intervalle de confiance.
Des variantes le rendent praticable. L'échantillonnage stratifié tire au sort séparément dans des sous-groupes — âge, région — pour en garantir la représentation ; l'échantillonnage en grappes tire au sort des unités entières, écoles ou villages, quand aucune liste des individus n'existe.
Un échantillon de volontaires, de patients hospitalisés ou de personnes jointes par internet n'est pas représentatif de la population générale. On peut en tirer des estimations précises, mais qui décrivent une autre population que celle qu'on croit étudier.
Deux calculs types
Sur un échantillon de 100 adultes, la pression systolique moyenne est de 120 mmHg, avec un écart-type de 15 mmHg. L'erreur standard de la moyenne vaut l'écart-type divisé par la racine de l'effectif : 15 / 10 = 1,5 mmHg. L'intervalle de confiance à 95 % s'étend à 1,96 erreur standard de part et d'autre de la moyenne, soit environ 120 ± 2,9, c'est-à-dire de 117,1 à 122,9 mmHg.
Sur 400 personnes interrogées, 80 sont fumeuses : la proportion observée est de 20 %. Son erreur standard vaut la racine de p(1 − p)/n, soit la racine de 0,2 × 0,8 / 400 = 0,02. L'intervalle à 95 % vaut 20 % ± 1,96 × 2 %, soit environ de 16 % à 24 %.
Ces formules reposent sur l'approximation normale. Pour une proportion, elle est acceptable quand on attend au moins cinq sujets de chaque catégorie, soit n × p et n × (1 − p) au moins égaux à 5. Pour une moyenne sur un petit échantillon, on remplace 1,96 par une valeur un peu plus grande, tirée de la loi de Student, qui dépend de l'effectif.
Quelques lois de probabilité
La loi binomiale décrit le nombre de succès dans une série de n épreuves indépendantes ayant chacune la même probabilité p de succès : le nombre de garçons dans une fratrie, le nombre de patients guéris sur n traités. Sa moyenne vaut n × p. Quand n est grand, elle se rapproche d'une loi normale.
La loi de Poisson décrit le nombre d'événements rares survenant dans un intervalle de temps ou d'espace, comme le nombre de cas d'une maladie rare par an dans une région. Sa moyenne et sa variance sont égales.
La loi normale est la plus utilisée, non parce que toutes les variables biologiques sont normales — beaucoup ne le sont pas — mais parce que, selon le théorème central limite, la moyenne d'un échantillon suffisamment grand suit approximativement une loi normale, quelle que soit la distribution de départ. C'est ce qui justifie les intervalles de confiance et beaucoup de tests.
Précision et exactitude
Une estimation peut se tromper de deux façons. L'erreur aléatoire, due à la fluctuation d'échantillonnage, disperse les estimations autour de la vraie valeur : elle diminue quand l'effectif augmente, et l'intervalle de confiance la mesure. L'erreur systématique, ou biais, décale toutes les estimations dans le même sens : elle ne diminue pas avec l'effectif, et l'intervalle de confiance ne la voit pas.
L'image de la cible aide à retenir la différence. Des tirs groupés mais loin du centre sont précis mais biaisés ; des tirs dispersés autour du centre sont exacts en moyenne mais imprécis. Une grande étude biaisée donne un intervalle étroit… autour d'une valeur fausse.
Les biais se classent en trois familles. Le biais de sélection vient de la façon dont les sujets sont recrutés : des volontaires en meilleure santé que la population, des perdus de vue différents de ceux qui restent. Le biais de mesure, ou d'information, vient de la façon dont les données sont recueillies : un appareil mal étalonné, des malades qui se souviennent mieux de leurs expositions que les témoins. Le biais de confusion vient d'un troisième facteur lié à la fois à l'exposition et au résultat.
Combien de sujets inclure
Avant une étude, on calcule le nombre de sujets nécessaires pour avoir de bonnes chances de mettre en évidence l'effet recherché s'il existe. Ce nombre augmente quand on veut un risque alpha plus faible, une puissance plus élevée, quand la variabilité de la mesure est grande, et surtout quand l'effet recherché est petit.
L'effectif varie comme l'inverse du carré de l'effet : pour détecter un effet deux fois plus petit, il faut environ quatre fois plus de sujets. C'est pourquoi les études qui cherchent de petits bénéfices, par exemple une faible réduction de mortalité, incluent des milliers ou des dizaines de milliers de patients.
Une étude trop petite a peu de chances de conclure même si le traitement est efficace, et ses résultats positifs, quand ils surviennent, surestiment souvent l'effet. Recruter des patients dans une étude qui ne peut pas répondre à sa question pose aussi un problème éthique.
Lire l'intervalle d'un effet
On estime souvent non une moyenne mais un effet : différence entre deux moyennes, risque relatif, rapport de cotes. L'intervalle de confiance d'une différence se lit par rapport à 0, valeur qui signifie l'absence de différence ; celui d'un rapport se lit par rapport à 1. Si l'intervalle à 95 % contient la valeur d'absence d'effet, la différence n'est pas significative au risque de 5 %, et inversement : test et intervalle disent la même chose.
L'intervalle dit pourtant beaucoup plus qu'un simple p. Un risque relatif de 0,80 avec un intervalle de 0,70 à 0,91 indique une réduction du risque comprise, de façon plausible, entre 9 % et 30 %. Un risque relatif de 0,80 avec un intervalle de 0,50 à 1,30 est compatible aussi bien avec un bénéfice important qu'avec un effet nul, voire nuisible : l'étude n'a pas tranché.
Pour juger de la pertinence clinique, on regarde la borne la moins favorable de l'intervalle : si même elle correspond à un bénéfice utile pour les patients, le résultat est à la fois significatif et cliniquement important.
58 questions corrigées accompagnent ce chapitre dans l'entraînement.
Sources et lectures
Ouvrages de référence
- Daniel Schwartz, Méthodes statistiques à l'usage des médecins et des biologistes, Flammarion Médecine-Sciences.
En accès libre
- 7.2 The Central Limit Theorem for Sums — OpenStax, Introductory Statistics 2e.
- 8.1 A Single Population Mean using the Normal Distribution — OpenStax, Introductory Statistics 2e.
Dernière révision : . Texte sous licence CC BY-SA 4.0.